搜索
当前所在位置: 首页>行业新闻

全球巨头砸钱超3800亿 工业富联涨停引爆算力板块

发布时间:2026-05-27 09:21:07 作者:超级管理员 点击:11 【 字体:大 中 小 】

5月13日,A股市场274.18亿元的成交额,让一只股票刷新了历史纪录——这个数字,相当于当天所有A股总成交额的近1%,全部涌向了同一家公司:工业富联。这只市值超过1.4万亿元 的巨头在午后涨停,并带动整个算力产业链集体爆发。

算力产业链集体爆发

全球巨头“烧钱”竞赛,钱会流向哪里?

这场行情最直接的导火索,是市场对国内科技巨头即将公布“成绩单”的强烈预期。就在5月13日晚间,阿里巴巴和腾讯将发布最新财报,而市场早已闻风而动。

阿里巴巴已经宣布,未来三年将投入超过3800亿元用于云和AI硬件基础设施建设,这个数字超过了其过去十年的总和。其2026财年(截至2026年3月)整体资本开支预计在1450-1500亿元之间,其中75%以上将投向AI领域。

腾讯则计划在2026年将对AI新产品的投入翻倍,达到至少360亿元。就在刚刚过去的一季度,腾讯的资本开支付款中,有370亿元明确用于支持AI相关投入。

国内巨头的手笔已经令人咋舌,但全球范围的“军备竞赛”规模更为惊人。北美四大云服务商(亚马逊、微软、谷歌、Meta)在2026年第一季度的资本开支合计高达1316亿美元,同比增长超过70%。中信建投的研报指出,这四家公司全年的资本开支指引中值合计预计达到7100亿美元。

▲ CPO(共封装光学)技术成为AI基础设施破局关键

技术突破“卡脖子”,谁在解决关键瓶颈?

钱要花在刀刃上。当AI数据中心的规模越来越大,传统的数据传输方式就像用狭窄的乡间小路运输巨型货轮,速度和能耗都成了瓶颈。这时,一项名为CPO(共封装光学)的技术成为了破局关键。

你可以把它理解为,把原本分开的光模块和芯片,像同桌一样“封装”在一起协同工作,从而大幅提升传输效率、降低能耗。这项技术能解决AI高密度计算的功耗难题,被英伟达创始人黄仁勋视为下一代AI基础设施的必需品。

5月13日引爆市场的另一则消息,正与此相关:工业富联的母公司鸿海集团,其全光CPO交换机机柜已提前向大客户英伟达出货。更关键的是,出货预期从原计划的2026年超1万台,大幅上调至2026至2027年合计超过5万台。

这对工业富联意味着什么?传统服务器代工业务的毛利率仅在5%-8%,而CPO交换机的毛利率能达到两位数。机构预测,2026年CPO业务将为工业富联贡献15%以上的营收,成为继AI服务器之后的第二增长曲线。这不仅是量的增长,更是盈利结构的质变。

A股产业链,如何承接这场“泼天富贵”?

全球需求爆发与技术突破共振,最终在A股市场形成了清晰的传导链条。5月13日,资金不仅追捧了工业富联这样的整机龙头,更全面激活了整个算力生态:

光通信核心组件直接受益:CPO技术的规模化应用,将直接利好光引擎、硅光芯片等上游供应商。当日,天孚通信、中际旭创等相关概念股均出现上涨。

算力基础设施全面升温:在“东数西算”等政策推动下,算力租赁、数据中心板块同样表现强势。东数西算板块指数当日上涨4%,成交1226.01亿元。润建股份、城地香江等多只算力租赁概念股涨停。

资金共识高度集中:当日,代表电子行业的主力资金净流入超过645亿元,位居所有行业第一。全市场成交额连续第6日突破3万亿元,显示出充沛的流动性正在聚焦科技主线。

▲ AI服务器成为算力投资的核心硬件载体

所以,接下来你该盯着什么?

对于普通投资者而言,理解这场算力狂潮的逻辑,比追逐短期涨停更重要。它揭示了一个清晰的路径:AI应用的爆发→巨头资本开支激增→上游硬件技术迭代→产业链公司业绩兑现。

接下来,有几个关键节点值得关注:

财报季的验证:密切关注阿里巴巴、腾讯等巨头财报中关于AI资本开支的具体细节和未来指引,这是需求端的“温度计”。

技术进展的跟踪:CPO等先进技术的量产进度和成本下降曲线,将决定哪些公司能真正享受到技术红利。

政策节点的把握:国内“东数西算”工程的持续推进,以及国家对智算中心建设标准的落实,将带来结构性机会。

当英伟达创始人黄仁勋说“我们正在经历人类历史上规模最大的基础设施建设”时,他指的不仅是硅谷的实验室,也包括万里之外A股上市公司生产线上的轰鸣。这场盛宴的请柬,已经发出。


阅读全文
相关推荐

三步部署DeepSeek V4模型

三步部署DeepSeek V4模型
背景:DeepSeek V4其核心突破在于全系标配 100 万 token(约 75 万汉字)的超长上下文窗口‌,并针对效率与性能进行了系统性优化。目前发布了两个版本,分别为DeepSeekV4-Pro(旗舰版)‌ 和 ‌‌DeepSeek V4-Flash(轻量版),下面以DeepSeek V4-Flash(轻量版284B)部署为例展开。参考链接:https://docs.vllm.ai/projects/a...

西方锁死“空间”,华为征服“时间”:τ定律背后的算力大置换

西方锁死“空间”,华为征服“时间”:τ定律背后的算力大置换
5月25日,全网舆论场被娱乐热搜、日常琐事填满,大众沉浸在碎片化的热闹里,几乎无人留意,科技界悄然发生了一件改写人类半导体60年规则的里程碑事件。华为正式发布国产算力首个全球标准——韬(τ)定律。这不是一次普通的技术发布会,不是又一款芯片的迭代升级,更不是一场行业噱头式的概念炒作。这是一份赤裸裸的摩尔定律...

国内GPU卡全线飙涨原因分析

国内GPU卡全线飙涨原因分析
紧张升级5 月份,非常非常多的人寄希望于两个大佬谈判之后的的 GPU管制放松,特别是上一代 hopper架构的顶配算力卡松绑,弥补内部的算力不足,但是结果事与愿违,双方在 GPU 算力领域抓紧了卡脖子竞赛,彼此相互掐。(不要抱幻想了,干就完了)咱发布“韬定律”,引领未来半导体产业自主可控发展;对面发布史上最严 BIS 禁令...

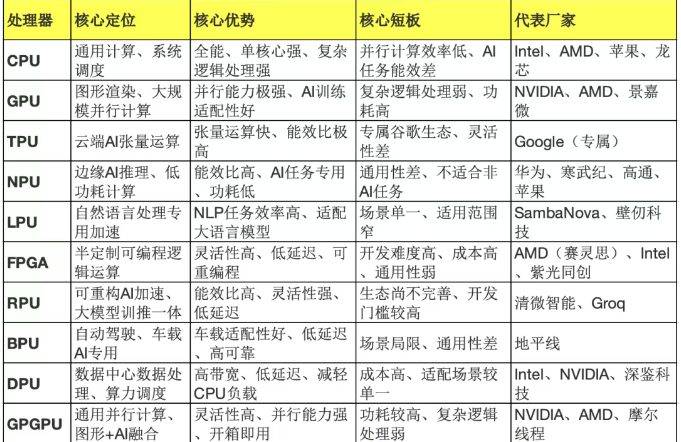
10大算力芯片全解析:CPU/GPU/TPU/NPU/LPU/FPGA......
10大算力芯片全解析:CPU/GPU/TPU/NPU/LPU/FPGA......
在 AI 大模型、自动驾驶、边缘计算全面爆发的今天,算力已经成为数字时代的 “新石油/新电力”,而承载算力的各类处理器芯片,就是驱动这场技术革命的 “发动机”。很多人都会有这样的困惑:CPU、GPU、TPU、NPU…… 这些长得差不多的缩写到底有什么区别?各自适合干什么?谁才是 AI 时代的 “王者”?10 大芯片核心定...

建议收藏:RTX 5090从卡和整机方面与4090相比,有何升级与变化
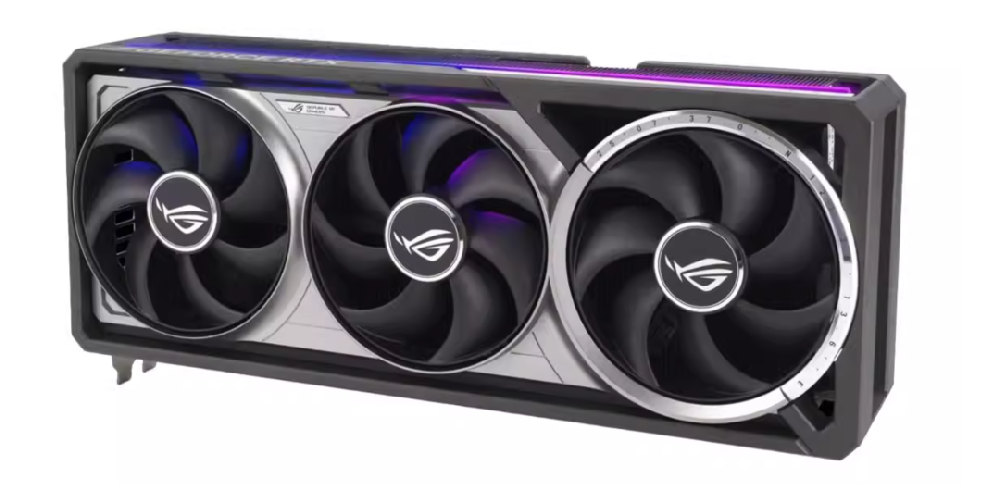
建议收藏:RTX 5090从卡和整机方面与4090相比,有何升级与变化
一、5090和4090 GPU卡的综合对比英伟达RTX 5090于2025年1月7日发布。采用最新的Blackwell架构,配备32GB GDDR7显存,显存带宽高达1792 GB/s,并支持第五代Tensor核心和第四代光线追踪核心。和上一代旗舰GeForce卡4090对比如下:GPU对比RTX 5090RTX 4090核心GB202AD102架构BlackwellAda LovelaceCUDA核心数21,76016384...

西柚云超算与云南联通正式达成战略合作,将共建云南科研超算中心节点

西柚云超算与云南联通正式达成战略合作,将共建云南科研超算中心节点
2026年5月25日消息,西柚云超算与中国联通云南昆明分公司在昆明正式签署战略合作协议,标志着双方将携手共建云南科研超算中心节点,共同推动云南省算力基础设施建设与数字经济发展。根据战略合作协议,双方将围绕联通环湖东湖机房开展深度合作,依托该机房优质的网络资源和电力保障条件,共同建设集高性能计算、大规模存储互...

总投资24亿!中国银联黄山数据中心园区项目正式通电

总投资24亿!中国银联黄山数据中心园区项目正式通电
2026年5月23日消息,银联黄山园区项目10KV开关站A/B双回路于近日成功完成高压送电。据悉,银联黄山园区项目位于安徽省黄山市高新技术产业开发区丹霞路与银蝶湖北路交口东北侧部分地块(烟草公司和中科创新广场用地东侧,百川路南侧),是国家关键金融基础设施重要组成部分,也是安徽省重点项目和黄山市头号工程。该项目总投...

GPU服务器中的ETH、RDMA、GID、NVLink分别是什么?

GPU服务器中的ETH、RDMA、GID、NVLink分别是什么?
英伟达的旗舰机型,GB300的核心优势不止在于Grace CPU+Blackwell Ultra GPU的超强硬件配置,更在于一套分层、高速、低延迟的互联传输体系。很多时候会被四个名词绕晕:ETH、GID、RDMA、NVLink。它们到底各自是什么?谁负责内网、谁负责外网?谁依赖谁、谁限制谁?算力跑不满、集群通信卡顿、RDMA掉线,根源大多藏在这四者的...

拟投产机柜数约9560个!中国建设银行内蒙古和林格尔新区数据中心一期交付使用
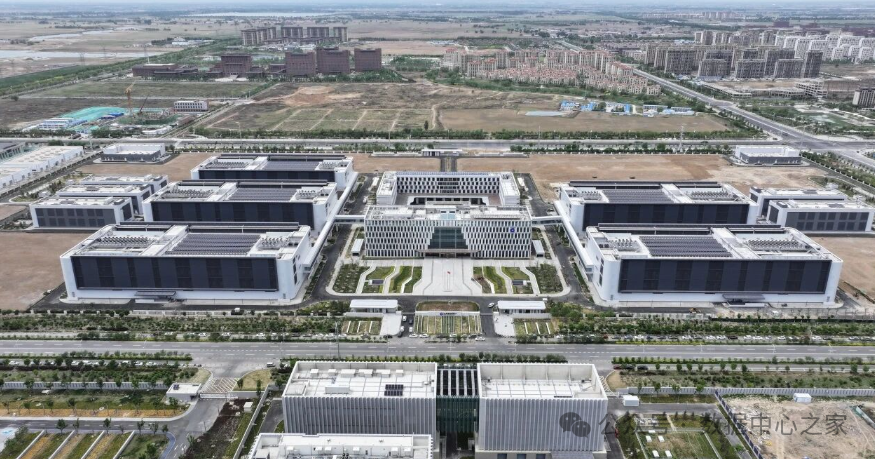
拟投产机柜数约9560个!中国建设银行内蒙古和林格尔新区数据中心一期交付使用
近日,中国建设银行内蒙古和林格尔新区数据中心一期顺利交付使用,这座百亿级数据中心将以澎湃算力赋能“草原云谷”数字经济高质量发展。据悉,中国建设银行内蒙古和林格尔新区数据中心项目位于呼和浩特市和林格尔新区云谷片区,占地面积569亩,总体规划建筑面积约52万平方米,计划总投资100亿元,采取分期建设,全部建成后...

国产卡是如何兼容CUDA的?

国产卡是如何兼容CUDA的?
都在说CUDA是英伟达最强的护城河,CUDA到底是什么?CUDA是英伟达在2006年推出的并行计算平台,简单说就是一套让程序员把计算任务扔给GPU跑的"语言+工具+规则"。听起来没什么特别,但问题在于,过去二十年,全球AI和深度学习的生态,几乎全部建立在CUDA之上。PyTorch、TensorFlow、各种大模型训练框架,底层都在调...
返回顶部