搜索
当前所在位置: 首页>智算中心

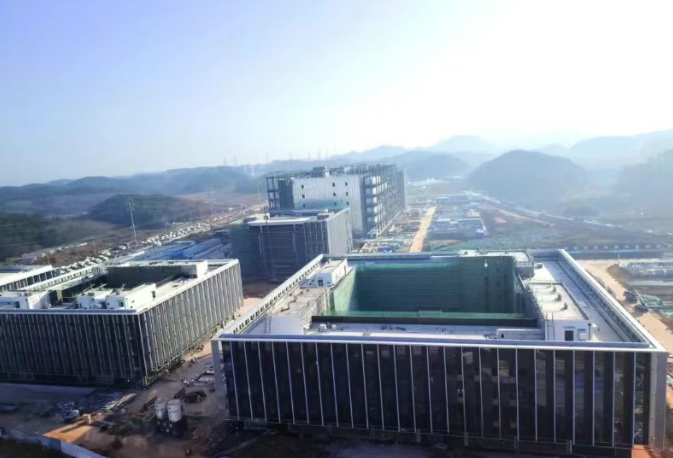
北京超智算人工智能创新示范园项目主体结构封顶

发布时间:2026-06-04 10:00:02 作者:超级管理员 点击:16 【 字体:大 中 小 】

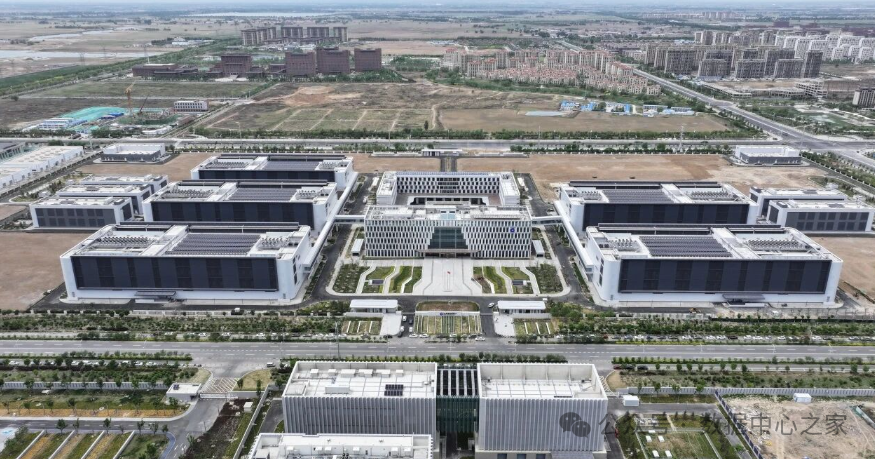
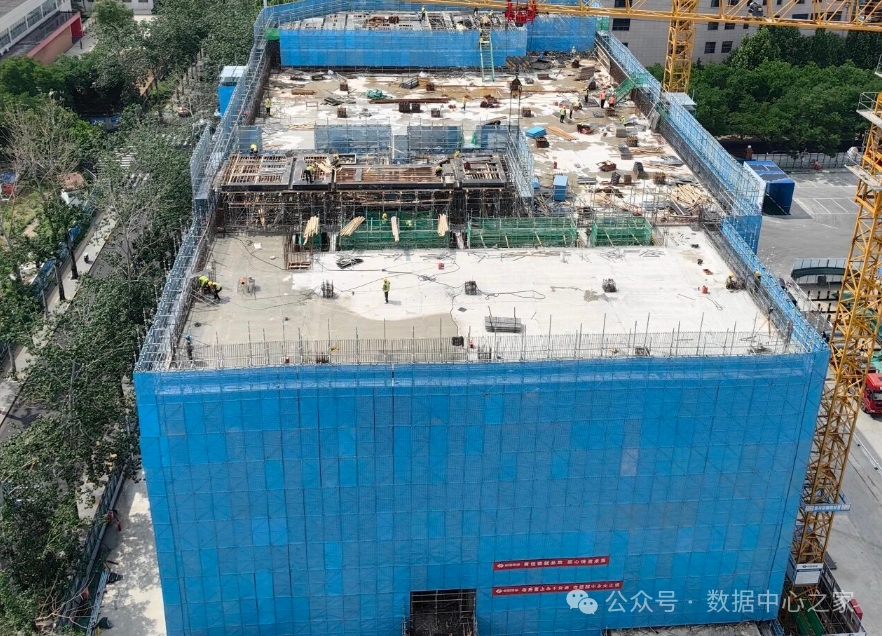
2026年6月3日,北京超智算人工智能创新示范园项目举行封顶仪式。项目于5月26日圆满完成主体结构封顶施工,顺利达成阶段性建设目标,为后续室内装修、专项验收、正式投产等工作有序推进夯实了坚实基础。

北京超智算人工智能创新示范园项目主体结构封顶

作为北京市2025、2026年“3个100”重点工程,该项目位于中关村科技园区石景山园北II区创业创新园1606-634-2地块,规划用地面积为5586.72平方米,规划总建筑面积约为14761.18平方米,涉及总投资2.58亿元,计划建设可承载9000P智算中心的产业研发用房及配套设施。

在区委区政府、各委办局及京石科创集团、实兴集团的大力支持下,建设主体北京石景山超智算科技有限公司统筹发力,通过冬季施工、春节不停工等保障举措,联合各参建单位高效攻坚、抢抓工期。

自2025年10月正式开工以来,项目仅用95天便高效完成“正负零”以下结构施工,顺利转入地上施工阶段;在此基础上,各方持续提速增效,仅用119天完成全部地上主体结构封顶,项目总建设周期仅214天。高效的建设推进,既彰显了专业高效的建设实力,也为区域同类重点工程提质增效、精工建造树立了标杆典范。

超智算人工智能创新示范园定位为集技术研发、产业集聚、应用示范与人才培养于一体的综合性人工智能产业载体。项目建成后,将成为区域人工智能产业发展的重要支撑支点,在推动人工智能与地方传统产业深度融合、优化区域产业结构的同时,精准赋能石景山区 “2+4+4” 高质量产业布局落地,加速人工智能产业集群成型,助力北京相关产业基础设施建设提速升级。

阅读全文
相关推荐

总投资24亿!中国银联黄山数据中心园区项目正式通电

总投资24亿!中国银联黄山数据中心园区项目正式通电
2026年5月23日消息,银联黄山园区项目10KV开关站A/B双回路于近日成功完成高压送电。据悉,银联黄山园区项目位于安徽省黄山市高新技术产业开发区丹霞路与银蝶湖北路交口东北侧部分地块(烟草公司和中科创新广场用地东侧,百川路南侧),是国家关键金融基础设施重要组成部分,也是安徽省重点项目和黄山市头号工程。该项目总投...

西方锁死“空间”,华为征服“时间”:τ定律背后的算力大置换

西方锁死“空间”,华为征服“时间”:τ定律背后的算力大置换
5月25日,全网舆论场被娱乐热搜、日常琐事填满,大众沉浸在碎片化的热闹里,几乎无人留意,科技界悄然发生了一件改写人类半导体60年规则的里程碑事件。华为正式发布国产算力首个全球标准——韬(τ)定律。这不是一次普通的技术发布会,不是又一款芯片的迭代升级,更不是一场行业噱头式的概念炒作。这是一份赤裸裸的摩尔定律...

锁死!美国禁止 AI 芯片出售:中国境外子公司

锁死!美国禁止 AI 芯片出售:中国境外子公司
2026 年 5 月 31 日,美国商务部工业与安全局 BIS 发布指引,明确先进计算产品出口许可要求仍适用于总部位于 Country Group D:5 或中国澳门地区的实体,以及最终母公司位于这些地区的实体。Country Group D:5 是美国 EAR《出口管理条例》中的国家分组,主要指受美国武器禁运的国家或地区;BIS 说明,该分组依据 EAR 第 740...

AutoDL 算力平台|弹性普惠算力,让 AI 开发零门槛

AutoDL 算力平台|弹性普惠算力,让 AI 开发零门槛
在 AI 技术普及的浪潮中,个人开发者、高校科研团队与中小企业,常面临算力成本高、环境配置复杂、资源弹性不足的痛点。AutoDL 作为国内领先的 C 端 AI 算力云平台,以 “弹性、好用、省钱” 为核心定位,深耕轻量化算力服务,凭借万卡级算力储备、开箱即用的开发环境、极致性价比的计费模式,成为 AI 开发者的首选算力伙伴...

算力成本失控:CPU两轮涨价超40%,内存半年翻倍,高端GPU租赁排到2027年
算力成本失控:CPU两轮涨价超40%,内存半年翻倍,高端GPU租赁排到2027年
本周服务器硬件全线紧缺态势未改。英特尔第二轮涨价于5月底正式落地,综合涨幅 40%~51% ;内存合约价Q1创单季暴涨 90%以上 历史纪录;高端GPU租赁价格年内再涨近 40% ,H200排期已延至 2027年Q2。AI产业正从“GPU独大”转向 全栈紧缺。一、CPU:涨价加速,两轮累计超40%服务器CPU价格持续走高,英特尔已完成两轮公开涨价:第...

2026 大模型 GPU 选型全指南|从消费游戏卡到超算卡,适配全系列 DeepSeek 模型部署
2026 大模型 GPU 选型全指南|从消费游戏卡到超算卡,适配全系列 DeepSeek 模型部署
随着 DeepSeek 全系列开源模型(1.5B/7B/13B/32B/67B/671B 稠密大模型)大范围落地私有化部署,显卡显存容量、单 / 双精度算力、显存带宽、多卡互联能力成为选型核心。市面上显卡分为:消费游戏卡(RTX3090/4090/5090)、专业可视化推理卡(A6000/L40/L40S/A10)、超算训练卡(A100/A800/H100/H800/H200) 三类,从硬件参数...

全球首个预制算力中心底座在山东青岛正式启用!

全球首个预制算力中心底座在山东青岛正式启用!
2026年6月6日,全球首个预制算力中心底座在山东青岛正式启用。相较于传统算力中心节约施工周期近70%,为当前算力基础设施建设提供更高效、更低碳的新方案。据悉,该算力中心底座长约53米,宽约41米,占地面积大概2200平方米。相较于传统算力中心底座,占地面积减少超30%,整体成本下降20%,最快5个月可以完成施工,土建成本...

国内GPU卡全线飙涨原因分析

国内GPU卡全线飙涨原因分析
紧张升级5 月份,非常非常多的人寄希望于两个大佬谈判之后的的 GPU管制放松,特别是上一代 hopper架构的顶配算力卡松绑,弥补内部的算力不足,但是结果事与愿违,双方在 GPU 算力领域抓紧了卡脖子竞赛,彼此相互掐。(不要抱幻想了,干就完了)咱发布“韬定律”,引领未来半导体产业自主可控发展;对面发布史上最严 BIS 禁令...

GPU服务器中的ETH、RDMA、GID、NVLink分别是什么?

GPU服务器中的ETH、RDMA、GID、NVLink分别是什么?
英伟达的旗舰机型,GB300的核心优势不止在于Grace CPU+Blackwell Ultra GPU的超强硬件配置,更在于一套分层、高速、低延迟的互联传输体系。很多时候会被四个名词绕晕:ETH、GID、RDMA、NVLink。它们到底各自是什么?谁负责内网、谁负责外网?谁依赖谁、谁限制谁?算力跑不满、集群通信卡顿、RDMA掉线,根源大多藏在这四者的...

国产卡是如何兼容CUDA的?

国产卡是如何兼容CUDA的?
都在说CUDA是英伟达最强的护城河,CUDA到底是什么?CUDA是英伟达在2006年推出的并行计算平台,简单说就是一套让程序员把计算任务扔给GPU跑的"语言+工具+规则"。听起来没什么特别,但问题在于,过去二十年,全球AI和深度学习的生态,几乎全部建立在CUDA之上。PyTorch、TensorFlow、各种大模型训练框架,底层都在调...
返回顶部