搜索
当前所在位置: 首页>技术支持

GPU服务器前端网络组网概述

发布时间:2026-06-17 09:13:39 作者:超级管理员 点击:10 【 字体:大 中 小 】

根据H100-GPU服务器确认各网络平面

针对H100-GPU服务器的配置清单,可进行网络平面划分:
single-400GE 8x (支持IB NDR/Ethernet OSFP),用于后端网络GPU分布式集群梯度同步
single-200GE 1x  (支持IB HDR/Ethernet QSFP56),用于对接存储网络
dual-25GE 1x(SFP+),用于对接前端网络

图片

注:single指Single Port (单口网卡),该板卡仅有一个接口(如一个 RJ45 电口或一个 SFP+/QSFP+ 光口);dual指Dual Port (双口网卡),即板卡拥有两个独立的接口。

Frontend Fabric(前端网络)概述

前端网络作用:一般用于接收推理请求,例如用户向大模型(豆包/GPT)问问题,这些推理请求流量会从前端网络接收发送给后端网络进行推理(南北向流量)。

如果要规划前端网络,则需要对流量模型进行拆分,用户位置可能位于互联网,也可能位于数据中心BorderLeaf专线互联的其他网络:

1、如果用户位于专线互联的其他网络:
用户 -> 用户侧接入交换机 -> 用户侧汇聚交换机 -> 用户侧核心交换机 -> 数据中心BorderLeaf -> 数据中心Spine -> 数据中心 ServiceLeaf -> 数据中心VAS -> 数据中心ServerLeaf -> H100前端网络端口
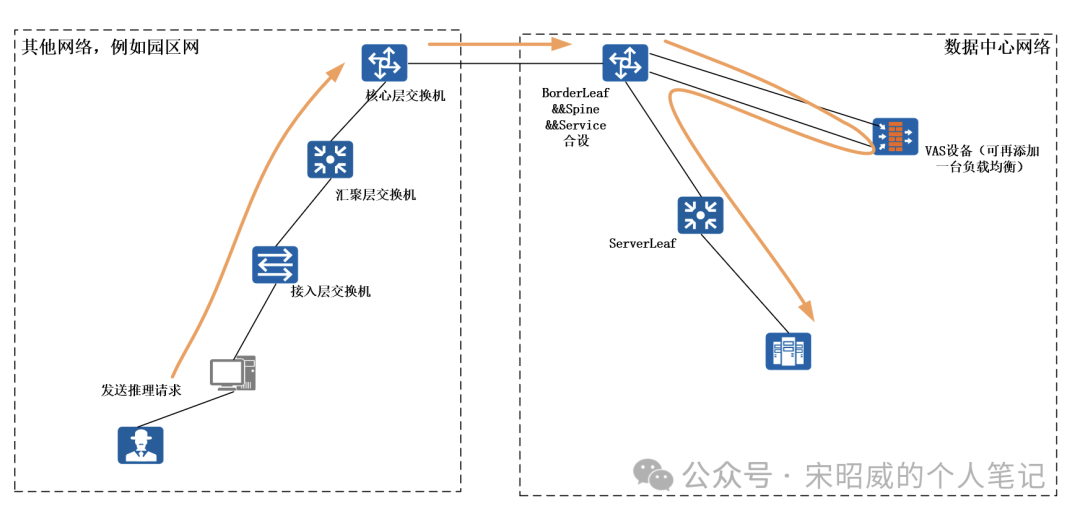
image.png

2、如果用户位于互联网
用户 -> 互联网 -> 数据中心PE -> 数据中心出口防火墙 -> 数据中心BorderLeaf -> 数据中心Spine -> 数据中心 ServiceLeaf -> 数据中心VAS -> 数据中心ServerLeaf -> H100前端网络端口
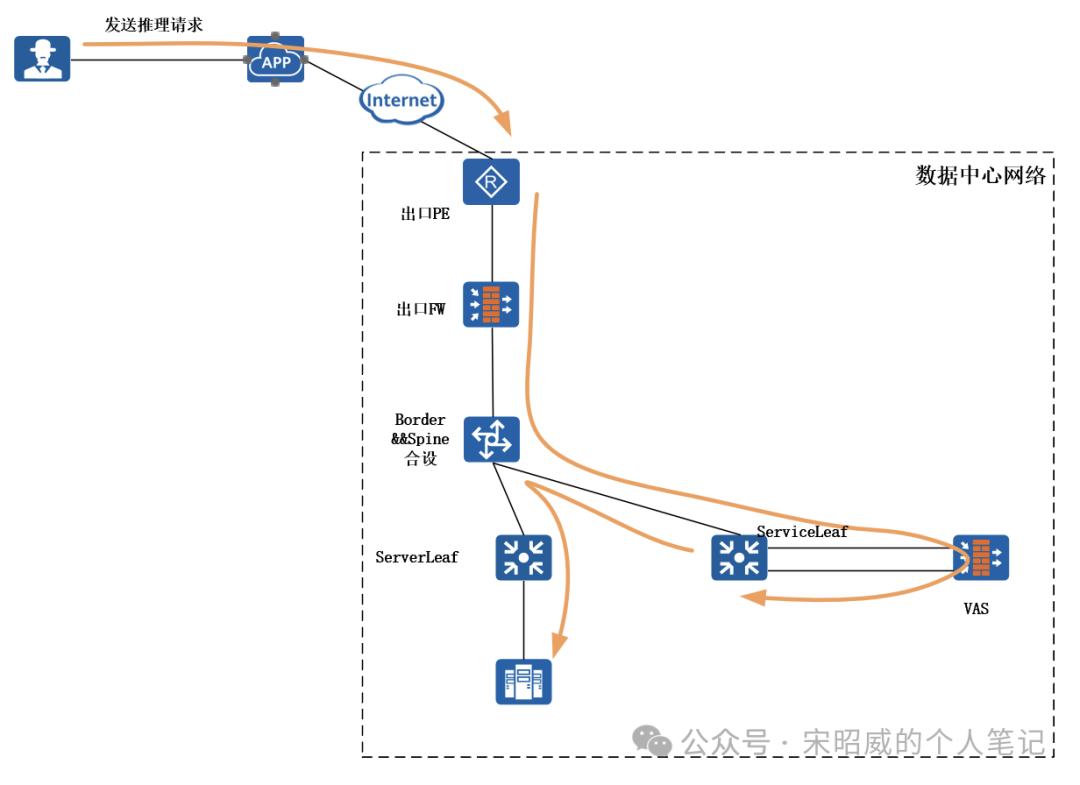
image.png

Frontend Fabric(前端网络)规划概述

所以,距离H100前端网络接口最近的TOR交换机ServerLeaf就是前端网络交换机。再根据前端网络接口的带宽速率,选择对应带宽速率的数据中心交换机(25GE)。
注:TOR=Top Of Rack,一个42U机柜中,与服务器同柜的交换机一般部署在机柜最顶部,当然也可以部署在机柜中间MOR或者机柜底部BOR。

对于收敛比,在前端网络规划中其实并不需要极致的1:1收敛比,但在推理场景中,为了保证极致的响应速度,也可以讲将前端网络的收敛比控制在 1:1 或 1.5:1 以内。
例如一台48口的25GE交换机(元创云端数据中心交换机),其上行接口8个100GE。若48个下行口全部接满,则收敛比为 48x25 : 100x8 = 1.5:1 ,满足业务需求。

图片

对于交换机功能特性,由于数据中心大部分为SDN/云化架构,所以需要考虑交换机支持:
可靠性:M-lag,支持数据中心分布式网关场景,提供网关双活和故障秒级切换,控制面独立,故障域隔离。
路由协议:BGP,控制策略丰富(优于OSPF/IS-IS/Static),支持属性扩展(MP-BGP)
虚拟化特性:VRF / VxLAN ,目前数据中心都为SDN架构的租户网络,通过VRF将数据中心隔离为多个租户网络,租户之间默认隔离。租户之间业务可通过VxLAN隧道进行通信/迁移。

阅读全文
相关推荐

国内GPU卡全线飙涨原因分析

国内GPU卡全线飙涨原因分析
紧张升级5 月份,非常非常多的人寄希望于两个大佬谈判之后的的 GPU管制放松,特别是上一代 hopper架构的顶配算力卡松绑,弥补内部的算力不足,但是结果事与愿违,双方在 GPU 算力领域抓紧了卡脖子竞赛,彼此相互掐。(不要抱幻想了,干就完了)咱发布“韬定律”,引领未来半导体产业自主可控发展;对面发布史上最严 BIS 禁令...

AI算力缺货从GPU烧到了一整条产业链?

AI算力缺货从GPU烧到了一整条产业链?
2026年,一场覆盖芯片、云、服务器与数据中心零部件的全产业链算力短缺正席卷全球。从GPU、CPU、HBM,到光模块、铜缆模块、高速交换机、电力与液冷设备,乃至云计算和Token资源,几乎全线供不应求。算力稀缺与全线涨价,已成为贯穿整个AI产业的核心叙事。这并非简单的供需错配,而是AI算力架构升级带来的系统性重构。01 需求...

上新!移动模型服务平台MoMA上架多款千问旗舰模型

上新!移动模型服务平台MoMA上架多款千问旗舰模型
AI“超级入口”再迎重磅升级!移动模型服务平台MoMA集中上架三大品类、多款千问优质旗舰模型,进一步扩充模型储备、拓宽应用场景,让用户便捷对接顶尖AI算力与模型资源,精准匹配各类AI使用需求。丰富模型矩阵,适配多元使用场景本次上新打破单一模型类型局限,以“汇聚更多模型能力”为核心,精准覆盖旗舰模型的高效适配与...

5月智算动态:信创GPU目录发布/tokens中转站被罚/B300回落/H2oo靴子落地/HBM3e需求爆发
5月智算动态:信创GPU目录发布/tokens中转站被罚/B300回落/H2oo靴子落地/HBM3e需求爆发
国产算力1.信创目录发布:第一批9颗信创算力芯片基于国产工艺(含封装),目录发布对各地方项目影响巨大地方态度:各地方政企“吹风”优先支持本地进目录的产品运营商态度:运营商自采项目“吹风”只能采购目录产品测试条件:前提条件,国产工艺(含代工),很多产品都送测了,第一批没进入,关键是代工(含封装)低点的问题...

算力成本失控:CPU两轮涨价超40%,内存半年翻倍,高端GPU租赁排到2027年
算力成本失控:CPU两轮涨价超40%,内存半年翻倍,高端GPU租赁排到2027年
本周服务器硬件全线紧缺态势未改。英特尔第二轮涨价于5月底正式落地,综合涨幅 40%~51% ;内存合约价Q1创单季暴涨 90%以上 历史纪录;高端GPU租赁价格年内再涨近 40% ,H200排期已延至 2027年Q2。AI产业正从“GPU独大”转向 全栈紧缺。一、CPU:涨价加速,两轮累计超40%服务器CPU价格持续走高,英特尔已完成两轮公开涨价:第...

GPU显卡驱动如何安装?

GPU显卡驱动如何安装?
注:GPU服务器建议不要升级内核版本,一旦升级内核后需要重新安装GPU驱动安装GPU驱动$apt-getinstallgccmake$apt-getupdate$wgethttp://cn.download.nvidia.com/XFree86/Linux-x86_64/440.44/NVIDIA-Linux-x86_64-440.44.run$sudochmod+xNVIDIA-Linux-x86_64-440.44.run$s...

Windows系统NVIDIA(英伟达)显卡驱动 安装详细流程

Windows系统NVIDIA(英伟达)显卡驱动 安装详细流程
1.打开浏览器输入【www.nvidia.cn】2.点击【驱动】3.点击【小三角(小图标)】;点击【GeForce】4.笔记本选择带有后缀(Notebooks)的;这里以【笔记本4060显卡】为例①点击【小三角(小图标)】;②点击 GeForce RTX 40Series(Notebooks)】5.笔记本选择带有后缀(Notebooks)的;这里以【笔记本4060显卡】为例①点...

不用花一分钱!Claude Code接入DeepSeekV4完整教程

不用花一分钱!Claude Code接入DeepSeekV4完整教程
Claude Code 是官方出的命令行编程助手,它原本只能用自家的接口。但是用开源的CC Switch工具,就能把它底层换成 DeepSeek V4,再用上国内平台的免费额度,一分钱不花就能直接用。DeepSeek V4 分两个版本:DeepSeek V4 Flash:轻便又反应快,平时简单写代码、做辅助刚刚好DeepSeek V4 Pro:性能更强,适合处理那种难度高、逻...

万亿空间!NVIDIA 2027财年第一季度财务报告深度解读!

万亿空间!NVIDIA 2027财年第一季度财务报告深度解读!
AI基础设施的投资浪潮,早已跨过概念炒作阶段,进入实打实的业绩兑现周期。美东时间5月20日,英伟达发布2027财年第一季度重磅财报,交出了一份颠覆行业预期的成绩单。即便彻底失去中国主流AI芯片市场,英伟达依旧创下单季营收、净利润双历史新高,用硬核数据印证了自身在全球AI产业链的绝对统治力。更值得关注的是,这份财报...

豆包即将将“正式收费”!

豆包即将将“正式收费”!
据报,知情人士透露,豆包预计将在6月下旬正式上线付费内容,并于同期举行的Force大会上更新相关功能。之所以选择这一时间节点,是因为PC端与移动端仍需约一个月时间,完成基础功能与收费体系的适配改造。若进展顺利,豆包将于三季度进一步结合电商功能更新完善付费场景,并通过补贴为抖音商城进行引流,四季度进入运行期。...
返回顶部