搜索
当前所在位置: 首页>模型API

2026 大模型 GPU 选型全指南|从消费游戏卡到超算卡,适配全系列 DeepSeek 模型部署

发布时间:2026-06-17 09:12:36 作者:超级管理员 点击:54 【 字体:

随着 DeepSeek 全系列开源模型(1.5B/7B/13B/32B/67B/671B 稠密大模型)大范围落地私有化部署,显卡显存容量、单 / 双精度算力、显存带宽、多卡互联能力成为选型核心。市面上显卡分为:消费游戏卡(RTX3090/4090/5090)、专业可视化推理卡(A6000/L40/L40S/A10)、超算训练卡(A100/A800/H100/H800/H200) 三类,从硬件参数、实测算力、模型适配、整机方案四大维度完整拆解选型逻辑。

一、全品类主流显卡分类与详细硬件参数详解

分类 1:消费级游戏显卡(RTX3090/4090/5090,Ada/Ampere/Blackwell 架构)主打性价比推理、小参数量模型微调,双精度 FP64 硬件阉割(游戏无需求),显存 GDDR 高速显存,无 NVLink 专业互联,个人 / 台式机首选。

型号
架构
显存
显存位宽 / 带宽
功耗
核心定位
RTX3090
Ampere
24GB GDDR6
384bit/936GB/s
450W
老款主力推理卡,二手性价比首选
RTX4090
Ada Lovelace
24GB GDDR6X
384bit/1008GB/s
450W
当前消费级 AI 标杆,7~34B 量化首选
RTX5090
Blackwell
32GB GDDR7
512bit/1792GB/s
500W
新一代消费天花板,原生扛 70B 量化推理


分类 2:数据中心专业图形 / 推理卡(A6000、L40、L40S、A10,Ada/Ampere)面向企业推理、AI 绘图、多模态,FP64 优于游戏卡、ECC 纠错显存、全尺寸 PCIe、7×24 小时稳定运行,工作站标配,兼顾微调与高并发推理。

型号
架构
显存
显存带宽
功耗
核心定位
A10
Ampere
24GB GDDR6
600GB/s
150W
低功耗批量推理,云端轻量部署
A6000
Ada
48GB GDDR6
930GB/s
300W
48GB 大显存,单卡原生跑 34B 量化
L40
Ada
48GB GDDR6
930GB/s
300W
替代 A6000,AI 生成 + 大模型推理通用
L40S
Ada
48GB GDDR6
1300GB/s
350W
L40 满血升级版,Tensor 算力大幅提升

分类 3:Tesla 超算 HBM 超算卡(A100/A800/H100/H800/H200,Hopper/Ampere)HBM 高带宽显存、满血 FP64 双精度、NVSwitch 高速互联、原生多卡集群训练,稠密大模型全参数训练刚需,企业 / 超算机房专用;A800/H800 为国内合规版,对标 A100/H100 规格、削减互联带宽合规出口。

型号
架构
显存
显存带宽
功耗
核心定位
A100 80G
Ampere
80GB HBM2e
1.935TB/s
400W
7B~67B 全参数训练经典卡
A800 80G
Ampere
80GB HBM2e
1.935TB/s
400W
国内替代 A100 合规版,参数一致
H100 80G
Hopper
80GB HBM3
3.35TB/s
700W
新一代训练主力,FP8 原生硬件加速
H800 80G
Hopper
80GB HBM3
3.35TB/s
700W
H100 国内合规替代款
H200 141G
Hopper
141GB HBM3e
4.8TB/s
750W
超大显存旗舰,单卡容纳 67B FP16 稠密模型


二、实测算力对比:FP32 单精度、FP64 双精度(英伟达官方 + 第三方实测公开数据)

关键科普:FP64 双精度 = 科学计算 / 全参数大模型训练刚需;FP32 单精度 = 通用 AI 训练;BF16/FP8 = 大模型主流推理 / 微调精度(Tensor Core 算力);游戏卡普遍阉割 FP64,超算卡满血双精度是核心区分点


全卡算力汇总表(单位:TFLOPS,理论 + 实测落地值)

显卡型号
FP32 单精度 (实测)
FP64 双精度 (实测)
BF16 Tensor (稀疏)
RTX3090
35.6
0.56(阉割 1/64)
285
RTX4090
83
1.3(阉割 1/64)
660
RTX5090
132
2.1(阉割 1/64)
1056
A10
23
2.9
184
A6000
91
5.7
728
L40
90
5.6
720
L40S
120
7.5
960
A100 80G
19.5
9.7(满血)
624
A800 80G
19.5
9.7(满血)
624
H100 80G
60
30(满血)
1850
H800 80G
60
30(满血)
1850
H200 141G
67
34(满血)
1979

算力总结

  1. 消费卡:FP32 不错、FP64 残废,只适合量化推理、少量 LoRA 微调

,严禁全参数稠密训练;
专业推理卡(A6000/L40S):FP64 约为超算卡一半,兼顾推理 + 中小模型微调,性价比高于 H 卡;

  1. Tesla 超算卡(A/H 系列):FP64 满血,全参数大模型训练唯一选择,H100/H200 原生 FP8 硬件,推理 / 训练双提速 3~5 倍。


三、基于 DeepSeek 全系列参数量(1.5B~671B)精准显卡选型|低端入门→高端企业级
1. 低端入门方案(个人 / 学生,台式机部署,量化推理为主)

DeepSeek 模型
显存需求 (FP16/INT4)
推荐显卡
使用场景
DeepSeek-1.5B
3GB/0.8GB
RTX3090 二手 / 4060Ti 16G
个人学习、本地聊天机器人、Ollama 一键部署
DeepSeek-7B
14GB/4GB
单卡 RTX3090/4090
个人开发、低并发对话、小数据集微调

2. 中端性价比方案(工作室 / 小团队,13B~32B,推理 + LoRA 微调)

DeepSeek 模型
显存需求 (FP16/INT4)
推荐显卡
使用场景
DeepSeek-13B
26GB/7GB
双卡 RTX4090 / 单卡 A6000/L40
私有化 API 服务、数十并发、模型微调
DeepSeek-32B
64GB/16GB
双 A6000 / 4 张 3090
企业知识库落地、行业微调、批量文档解析

3. 高端企业方案(中大型公司 / 实验室,67B~671B 稠密模型,全参数训练 + 高并发推理)

DeepSeek 模型
显存需求 (FP16/INT4)
推荐显卡
使用场景
DeepSeek-67B
134GB/34GB
A100 80G×2 / H100×1 / H200 单卡
全参数微调、商用高并发 Serving、多模态融合
DeepSeek-671B 稠密
1350GB+/338GB+
H100/H800 80G×16 起(NVSwitch 集群)
原生全参数预训练、千亿级基座研发、超算级私有化部署

选型口诀

  • 7B 以内个人玩:RTX4090/5090 闭眼入;
  • 13~34B 企业推理:A6000/L40S 性价比之王;
  • ≥67B 全参数训练:必上 A800/H800/H200 超算卡。


四、四大落地整机方案:台式机|塔式工作站|机架服务器|GPU 集群(对应 DeepSeek 不同量级)
方案 1:个人台式机(DeepSeek 1.5B~7B,纯推理 / 轻量微调,预算 0.8w~3w)

CPU:i9-14900K/R9 9950X;内存 64GB DDR5;NVMe 2TB 固态;金牌 850W~1200W 电源;显卡二选一

  1. 性价比:二手 RTX3090 24G(1万左右),跑 7B INT4;
  2. 顶配:RTX5090 32G(4w左右),单卡 7B FP16 原生推理、13B 量化。


方案 2:塔式 AI 工作站(DeepSeek13B~32B,中小团队 7×24 小时运行,预算 5w~20w)
支持 1~4 张全尺寸显卡,ECC 内存、静音液冷,办公机房无需机柜标配:双路 Xeon / 线程撕裂者 PRO;128~512GB ECC 内存;4TB 企业固态;2000~4000W 冗余电源

  • 入门:2×RTX3090(整机 5w)→DeepSeek32B INT4;
  • 专业:2×A6000 48G(整机15w)→32B FP16 全精度微调、百并发推理。


方案 3:机架式单路服务器(DeepSeek32B~67B,企业私有化部署,预算 30w~150w,上架机房)
多台 8 卡 H800/H100 服务器 + IB 高速交换机 + 分布式存储,NVSwitch 整机互联、张量并行 TP / 流水线 PP 分布式训练标准集群节点:8×H800 80G SXM5 整机(单节点 8 卡 NVSwitch),多节点 IB 组网;16 卡起步即可分片加载 DeepSeek671B 量化,64 卡 + 支持全参数预训练

五、选购避坑总结


  1. 只做推理、不做全参数训练:优先 RTX5090/L40S,拒绝高价 A/H 超算卡;

  2. 需要全参数微调≥67B:放弃消费游戏卡,A800/H800/H200 为唯一合规选择;

  3. 二手采购:3090 性价比拉满,7×24 商用优先 A10/A6000 工业卡;

  4. DeepSeek 部署优先顺序:先量化(INT4)降显存,再按需升级显卡,大幅降低硬件成本。


阅读全文
相关推荐

约2.04亿元!中国移动庆阳数据中心这些工程项目拟7月开工!
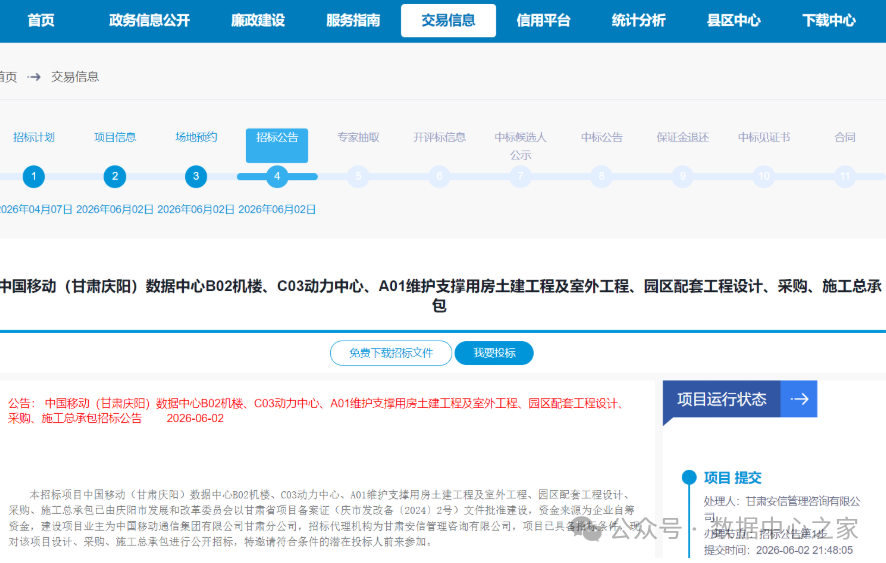
约2.04亿元!中国移动庆阳数据中心这些工程项目拟7月开工!
2026年6月2日,中国移动(甘肃庆阳)数据中心B02机楼、C03动力中心、A01维护支撑用房土建工程及室外工程、园区配套工程设计、采购、施工总承包招标公告发布。公告显示,本次招标项目建设地点为庆阳市西峰区“东数西算”产业园区内,工程内容包括:B02机楼土建工程:总建筑面积约25870㎡(含地下生产水池及泵房、光缆进线间,...

总投资24亿!中国银联黄山数据中心园区项目正式通电

总投资24亿!中国银联黄山数据中心园区项目正式通电
2026年5月23日消息,银联黄山园区项目10KV开关站A/B双回路于近日成功完成高压送电。据悉,银联黄山园区项目位于安徽省黄山市高新技术产业开发区丹霞路与银蝶湖北路交口东北侧部分地块(烟草公司和中科创新广场用地东侧,百川路南侧),是国家关键金融基础设施重要组成部分,也是安徽省重点项目和黄山市头号工程。该项目总投...

三步部署DeepSeek V4模型

三步部署DeepSeek V4模型
背景:DeepSeek V4其核心突破在于全系标配 100 万 token(约 75 万汉字)的超长上下文窗口‌,并针对效率与性能进行了系统性优化。目前发布了两个版本,分别为DeepSeekV4-Pro(旗舰版)‌ 和 ‌‌DeepSeek V4-Flash(轻量版),下面以DeepSeek V4-Flash(轻量版284B)部署为例展开。参考链接:https://docs.vllm.ai/projects/a...

一期拟投资100亿!协鑫华南智算基地项目签约落户韶关

一期拟投资100亿!协鑫华南智算基地项目签约落户韶关
2026年6月23日,韶关市人民政府与协鑫能源科技股份有限公司在韶关市区举行合作框架协议暨协鑫华南智算基地项目签约仪式。根据协议,双方将聚焦智算中心项目、零碳园区及Token运营中心等方面深化合作,实现互惠互利、战略共赢。协鑫华南智算中心项目一期计划投资100亿元,规划建设8万个标准机柜的数据中心及相关配套设施,后...

一文搞懂算力网、算力并网、算网融合的区别与作用

一文搞懂算力网、算力并网、算网融合的区别与作用
一、先说一下它们分别是什么?1、算力网先来看一下官方对于算力网的定义:算力网是以高速智能网络为物理纽带,以统一标准、统一标识、统一调度为核心机制,统筹通用算力、智能算力、超级算力等全域异构资源,实现跨区域、跨层级、跨主体高效协同与按需供给的国家级数字基础设施。看起来比较宏观、抽象,也不太好理解。其实,...

建议收藏:RTX 5090从卡和整机方面与4090相比,有何升级与变化

建议收藏:RTX 5090从卡和整机方面与4090相比,有何升级与变化
一、5090和4090 GPU卡的综合对比英伟达RTX 5090于2025年1月7日发布。采用最新的Blackwell架构,配备32GB GDDR7显存,显存带宽高达1792 GB/s,并支持第五代Tensor核心和第四代光线追踪核心。和上一代旗舰GeForce卡4090对比如下:GPU对比RTX 5090RTX 4090核心GB202AD102架构BlackwellAda LovelaceCUDA核心数21,76016384...

北京 A100-40G 现货出租

北京 A100-40G 现货出租
GPU裸金属服务器-A100*8CPU: 2*Intel Xeon Gold 6248R(24Core,3.0GHz)内存:24*32GB系统盘:2*480GBSATA SSD数据盘:4*1.92TB NVMe SSD显卡:Nvidia A100 PCIE 40G *8网卡:1 x2*25GE价格:85000/月有效期:7天 压一付一 年闭口...

上新!移动模型服务平台MoMA上架多款千问旗舰模型

上新!移动模型服务平台MoMA上架多款千问旗舰模型
AI“超级入口”再迎重磅升级!移动模型服务平台MoMA集中上架三大品类、多款千问优质旗舰模型,进一步扩充模型储备、拓宽应用场景,让用户便捷对接顶尖AI算力与模型资源,精准匹配各类AI使用需求。丰富模型矩阵,适配多元使用场景本次上新打破单一模型类型局限,以“汇聚更多模型能力”为核心,精准覆盖旗舰模型的高效适配与...

AI算力缺货从GPU烧到了一整条产业链?

AI算力缺货从GPU烧到了一整条产业链?
2026年,一场覆盖芯片、云、服务器与数据中心零部件的全产业链算力短缺正席卷全球。从GPU、CPU、HBM,到光模块、铜缆模块、高速交换机、电力与液冷设备,乃至云计算和Token资源,几乎全线供不应求。算力稀缺与全线涨价,已成为贯穿整个AI产业的核心叙事。这并非简单的供需错配,而是AI算力架构升级带来的系统性重构。01 需求...

西方锁死“空间”,华为征服“时间”:τ定律背后的算力大置换

西方锁死“空间”,华为征服“时间”:τ定律背后的算力大置换
5月25日,全网舆论场被娱乐热搜、日常琐事填满,大众沉浸在碎片化的热闹里,几乎无人留意,科技界悄然发生了一件改写人类半导体60年规则的里程碑事件。华为正式发布国产算力首个全球标准——韬(τ)定律。这不是一次普通的技术发布会,不是又一款芯片的迭代升级,更不是一场行业噱头式的概念炒作。这是一份赤裸裸的摩尔定律...
返回顶部