
10大算力芯片全解析:CPU/GPU/TPU/NPU/LPU/FPGA......
发布时间:2026-05-25 14:04:33 作者:超级管理员 点击:263 【 字体:大 中 小 】

在 AI 大模型、自动驾驶、边缘计算全面爆发的今天,算力已经成为数字时代的 “新石油/新电力”,而承载算力的各类处理器芯片,就是驱动这场技术革命的 “发动机”。很多人都会有这样的困惑:CPU、GPU、TPU、NPU…… 这些长得差不多的缩写到底有什么区别?各自适合干什么?谁才是 AI 时代的 “王者”?
10 大芯片核心定位:各司其职,没有 “万能神卡”
很多人以为芯片就是 “越贵越强”,但实际上,每一类芯片都是为特定场景量身打造的,没有一款芯片能通吃所有任务。
核心优劣势拆解:看懂每款芯片的 “长板” 与 “短板”
1. CPU:全能但不极致的 “总指挥”
核心优势:单核性能拉满,复杂逻辑处理能力极强,是所有设备的 “系统基石”,能处理从系统调度到通用计算的全场景任务。
核心短板:并行计算效率极低,跑 AI 大模型这类海量并行任务时,能效比被 GPU、NPU 全面碾压。代表玩家:Intel、AMD、苹果、龙芯
2. GPU:AI 训练的 “绝对王者”
核心优势:拥有数千个计算核心,并行计算能力堪称 “天花板”,完美适配 AI 训练的海量矩阵运算,是当前大模型训练的绝对主力。
核心短板:复杂逻辑处理能力弱,功耗高,数据中心 GPU 的功耗动辄数百瓦,对散热和供电要求苛刻。代表玩家:NVIDIA、AMD、景嘉微
3. TPU:谷歌专属的 “云端特化引擎”
核心优势:专为张量运算设计,云端 AI 推理能效比极高,完美适配谷歌自家的 TensorFlow 生态,在谷歌云数据中心性能拉满。
核心短板:完全绑定谷歌生态,灵活性极差,无法适配其他厂商的框架和场景,不对外通用。代表玩家:Google(专属)
4. NPU:全场景 AI 算力的「专用加速引擎」
核心优势:AI 任务专用架构,能效比极高,覆盖从边缘终端到云端数据中心的全场景 AI 计算,既支持手机、IoT 等低功耗本地推理,也能支撑大模型训练与推理,是 AI 时代的核心算力载体。
核心短板:通用性弱,以 AI 任务为核心设计,不擅长复杂逻辑处理与通用计算,无法替代 CPU/GPU 的通用场景。不过也在进化中。代表玩家:华为、寒武纪、高通、苹果
5. LPU:大语言模型的 “专属加速器”
核心优势:针对 NLP(自然语言处理)任务深度优化,大语言模型推理效率远超通用芯片,完美适配对话 AI、内容生成等场景。
核心短板:场景单一,适用范围窄,除了 NLP 任务几乎没有其他用武之地。代表玩家:SambaNova、壁仞科技
6. FPGA:灵活定制的 “硬件乐高”
核心优势:可编程逻辑架构,灵活性拉满,可根据需求定制硬件逻辑,低延迟、可重编程,适合定制化、低延迟场景。
核心短板:开发难度高、成本高昂,通用性弱,需要专业团队进行硬件级开发,无法开箱即用。代表玩家:AMD(赛灵思)、Intel、紫光同创
7. RPU:可重构的 “AI 训推一体新势力”
核心优势:可重构架构兼顾灵活性与能效比,低延迟,支持大模型训练 + 推理一体化,是 AI 芯片领域的新兴势力。
核心短板:生态尚不完善,开发门槛较高,尚未形成成熟的通用生态,大规模落地仍需时间。代表玩家:清微智能、Groq
8. BPU:自动驾驶的 “车规级大脑”
核心优势:专为车载场景深度优化,低延迟、高可靠、车规级适配,是自动驾驶感知、决策、控制的核心算力载体。
核心短板:场景极度局限,通用性差,除了车载自动驾驶几乎没有其他应用场景。
代表玩家:地平线
9. DPU:数据中心的 “网络管家”
核心优势:专门处理数据中心网络、存储任务,高带宽、低延迟,能大幅减轻 CPU 的负载,提升数据中心整体效率。
核心短板:成本高,适配场景单一,仅适用于数据中心基础设施,无法用于终端设备。
代表玩家:Intel、NVIDIA、深鉴科技
10. GPGPU:通用并行的 “多面手”核心优势:基于 GPU 架构拓展通用计算能力,并行能力强、开箱即用,兼顾图形渲染与 AI 计算,适合通用并行计算场景。核心短板:功耗较高,复杂逻辑处理能力弱,相比专用 AI 芯片能效比有差距。代表玩家:NVIDIA、AMD、摩尔线程 AI 算力的未来:专用化、异构化是必然趋势 从这 10 类芯片的发展就能看出,AI 算力的未来绝对不是 “一款芯片通吃天下”,而是专用化 + 异构化的融合:专用化:针对 AI 训练、推理、NLP、自动驾驶等细分场景,诞生越来越多的专用加速芯片,用极致能效比替代通用芯片;异构化:CPU+GPU+NPU+DPU 的异构计算架构,会成为数据中心、智能终端的标准配置,让每款芯片都发挥自己的长板,实现算力的最优分配。
而在这场算力竞赛中,国产芯片也正在全面崛起:华为昇腾 NPU、寒武纪思元、地平线 BPU、壁仞科技 GPU、清微智能 RPU…… 越来越多的国产厂商正在打破海外垄断,构建自主可控的 AI 算力底座。



上新!移动模型服务平台MoMA上架多款千问旗舰模型
极智算算力平台|硬核算力底座,赋能 AI 全域高效落地
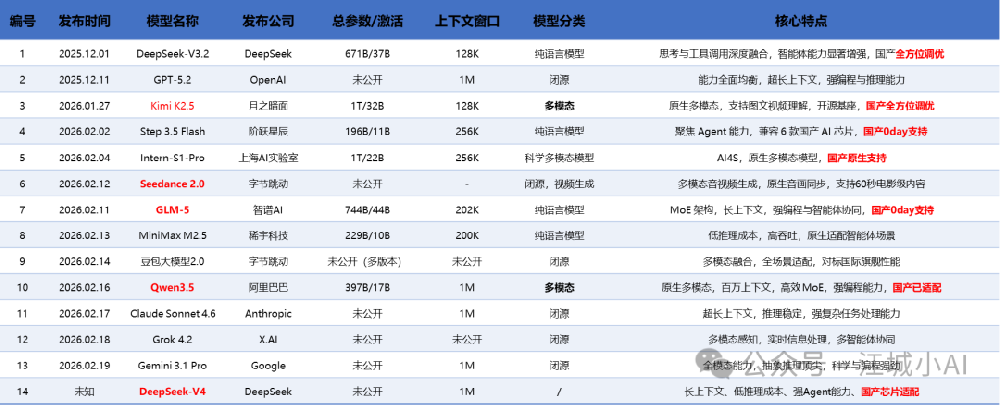
2026年大模型全景:国内外总览
GPU服务器前端网络组网概述
西柚云超算与云南联通正式达成战略合作,将共建云南科研超算中心节点
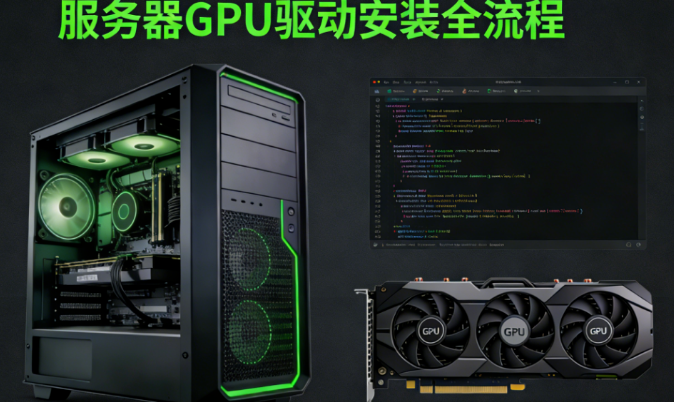
GPU显卡驱动如何安装?
GPU服务器中的ETH、RDMA、GID、NVLink分别是什么?
Windows系统NVIDIA(英伟达)显卡驱动 安装详细流程
一文搞懂算力网、算力并网、算网融合的区别与作用
不用花一分钱!Claude Code接入DeepSeekV4完整教程
极智算算力平台|硬核算力底座,赋能 AI 全域高效落地
10大算力芯片全解析:CPU/GPU/TPU/NPU/LPU/FPGA......
上新!移动模型服务平台MoMA上架多款千问旗舰模型
算力成本失控:CPU两轮涨价超40%,内存半年翻倍,高端GPU租赁排到2027年
北京 A100-40G 现货出租
建议收藏:RTX 5090从卡和整机方面与4090相比,有何升级与变化
不用花一分钱!Claude Code接入DeepSeekV4完整教程
国产卡是如何兼容CUDA的?
DeepSeek-V4.1 定档 6 月之核心技术深度前瞻!2026
5月智算动态:信创GPU目录发布/tokens中转站被罚/B300回落/H2oo靴子落地/HBM3e需求爆发