搜索
当前所在位置: 首页>算力百科

国产卡是如何兼容CUDA的?

发布时间:2026-05-28 10:44:08 作者:超级管理员 点击:13 【 字体:大 中 小 】

都在说CUDA是英伟达最强的护城河,CUDA到底是什么?CUDA是英伟达在2006年推出的并行计算平台,简单说就是一套让程序员把计算任务扔给GPU跑的"语言+工具+规则"。听起来没什么特别,但问题在于,过去二十年,全球AI和深度学习的生态,几乎全部建立在CUDA之上。PyTorch、TensorFlow、各种大模型训练框架,底层都在调用CUDA。全球数百万AI工程师,写的代码默认就是CUDA代码。这套生态的护城河,不是技术本身,而是习惯和惯性。

CUDA

当前时间节点买了一张国产GPU,性能可能不差,但跑不了CUDA代码,对大多数AI工程师来说,等于买了一台没有软件的电脑。

这是国产GPU厂商必须面对的问题:用户的代码是为CUDA写的,不是为你写的。你让一个工程师把几十万行代码全部重写来适配你的新平台?不现实。所以,怎么让为CUDA写的代码在我的卡上也能跑,成了每家国产GPU厂商都必须回答的问题。

业界大致摸索出了几条路。

第一条,是直接翻译源代码。工具扫描你的CUDA代码,把里面的API调用自动替换成国产平台的对应接口,就像把一本英文书逐字翻译成中文书,然后交给中文读者。华为昇腾的CANN平台提供了这类迁移工具。好处是转换后的代码原生跑在国产卡上,性能损耗小;坏处是翻译不可能百分之百完美,总有些翻不过来,需要工程师手动修改。

第二条,是运行时拦截。不改源代码,而是在程序运行的时候,悄悄拦截所有对CUDA的调用,实时转发给国产GPU的驱动。程序以为自己在调英伟达的库,背后已经被偷梁换柱了。这就像同声传译——你说英文,翻译官在旁边同步翻成中文,对方听到的是中文,整个过程你毫无感知。摩尔线程的MUSA、沐曦的MXMACA走的都是这条路,用户体验好,改动极少甚至零改动,但翻译层本身有性能开销,复杂的CUDA特性也可能翻译不了。

第三条,是干脆重建生态。不翻译,直接重新写一遍。华为的MindSpore框架是这条路的代表,思路最彻底,但现实很骨感——MindSpore的用户量和PyTorch相比差距悬殊,工程师们不愿意学一套新框架,除非被迫。所以这条路更多是长期战略,短期内解决不了兼容问题。

在这几条路之外,有一家公司走了一条完全不同的路,值得单独说说,那就是海光。

海光的DCU系列,底层架构脱胎于AMD,AMD有一套开源的GPU计算平台叫ROCm,其中有个接口叫HIP,HIP的API设计和CUDA高度相似,官方还提供了hipify工具,可以自动把CUDA代码转成HIP代码,转换率相当高。

海光DCU正是基于这套体系,推出了自己的软件栈DTK(DCU Toolkit)。不过在极致性能调优上也不如完全自研的架构灵活。但在短期内,这是国产卡里CUDA兼容性最好的方案之一。

兼容CUDA这个说法,其实是个程度问题,不是非黑即白。

CUDA经过二十年发展,API数量庞大,功能极其复杂。国产厂商的兼容层,通常能覆盖最常用的那20%接口,而这20%能跑通80%的主流模型。但如果你的代码深度依赖NVIDIA特有的硬件特性,比如Tensor Core的特定指令集,兼容层就可能翻车。更准确的说法是:国产卡在主流AI训练和推理场景下,已经能做到较好的CUDA兼容;但在边缘场景和极致性能优化上,仍有差距。

这件事之所以难,根本原因在于CUDA和国产GPU的底层架构存在根本性差异。NVIDIA GPU有自己独特的线程层级模型,国产GPU的硬件架构各不相同,有的更像DSP,有的更像向量处理器,CUDA的很多优化技巧在国产GPU上可能根本没有对应的硬件支持,细腻的表达,注定会丢失。

CUDA的护城河,本质是二十年的生态积累。国产GPU厂商正在做的事,是先用"翻译"让用户能用起来,再慢慢建立自己的生态。这条路很难,但没有捷径。


阅读全文
相关推荐

不用花一分钱!Claude Code接入DeepSeekV4完整教程
不用花一分钱!Claude Code接入DeepSeekV4完整教程
Claude Code 是官方出的命令行编程助手,它原本只能用自家的接口。但是用开源的CC Switch工具,就能把它底层换成 DeepSeek V4,再用上国内平台的免费额度,一分钱不花就能直接用。DeepSeek V4 分两个版本:DeepSeek V4 Flash:轻便又反应快,平时简单写代码、做辅助刚刚好DeepSeek V4 Pro:性能更强,适合处理那种难度高、逻...

单季暴增83.7%,NAND五大厂营收破389亿美元,SSD缺货涨价厂商赚麻了!
单季暴增83.7%,NAND五大厂营收破389亿美元,SSD缺货涨价厂商赚麻了!
当一块低速SATA固态硬盘的价格飙升至高性能NVMe产品的三倍,这不再是消费市场的价格异常,而是AI算力对存储产业链的一次彻底重塑。近日,海外市场出现了一幕足以载入硬件史册的定价倒挂:三星870 EVO SATA版本,1TB标价519美元,8TB更是高达4139美元(约合2.8万元人民币)。而同容量的WD_BLACK SN7100 NVMe固态,1TB仅售189...

算力成本失控:CPU两轮涨价超40%,内存半年翻倍,高端GPU租赁排到2027年
算力成本失控:CPU两轮涨价超40%,内存半年翻倍,高端GPU租赁排到2027年
本周服务器硬件全线紧缺态势未改。英特尔第二轮涨价于5月底正式落地,综合涨幅 40%~51% ;内存合约价Q1创单季暴涨 90%以上 历史纪录;高端GPU租赁价格年内再涨近 40% ,H200排期已延至 2027年Q2。AI产业正从“GPU独大”转向 全栈紧缺。一、CPU:涨价加速,两轮累计超40%服务器CPU价格持续走高,英特尔已完成两轮公开涨价:第...

上新!移动模型服务平台MoMA上架多款千问旗舰模型

上新!移动模型服务平台MoMA上架多款千问旗舰模型
AI“超级入口”再迎重磅升级!移动模型服务平台MoMA集中上架三大品类、多款千问优质旗舰模型,进一步扩充模型储备、拓宽应用场景,让用户便捷对接顶尖AI算力与模型资源,精准匹配各类AI使用需求。丰富模型矩阵,适配多元使用场景本次上新打破单一模型类型局限,以“汇聚更多模型能力”为核心,精准覆盖旗舰模型的高效适配与...

北京 A100-40G 现货出租

北京 A100-40G 现货出租
GPU裸金属服务器-A100*8CPU: 2*Intel Xeon Gold 6248R(24Core,3.0GHz)内存:24*32GB系统盘:2*480GBSATA SSD数据盘:4*1.92TB NVMe SSD显卡:Nvidia A100 PCIE 40G *8网卡:1 x2*25GE价格:85000/月有效期:7天 压一付一 年闭口...

10大算力芯片全解析:CPU/GPU/TPU/NPU/LPU/FPGA......
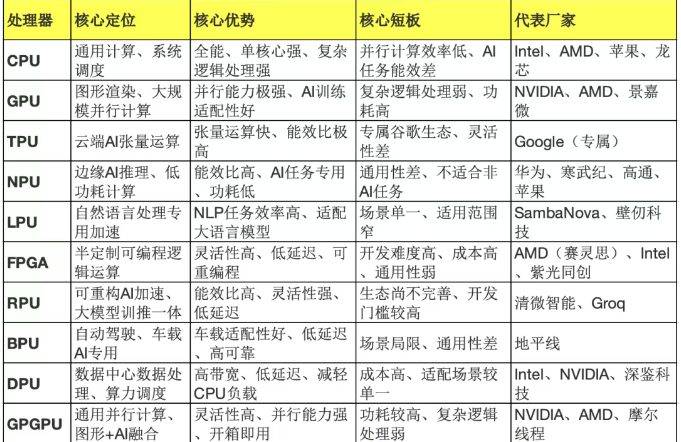
10大算力芯片全解析:CPU/GPU/TPU/NPU/LPU/FPGA......
在 AI 大模型、自动驾驶、边缘计算全面爆发的今天,算力已经成为数字时代的 “新石油/新电力”,而承载算力的各类处理器芯片,就是驱动这场技术革命的 “发动机”。很多人都会有这样的困惑:CPU、GPU、TPU、NPU…… 这些长得差不多的缩写到底有什么区别?各自适合干什么?谁才是 AI 时代的 “王者”?10 大芯片核心定...

2026年大模型全景:国内外总览

2026年大模型全景:国内外总览
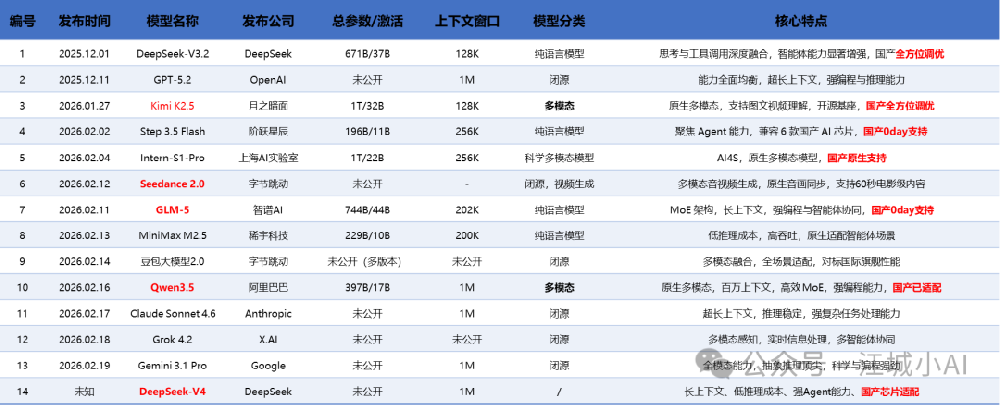
背景:2026 年全球大模型格局呈现国内以开源为主导、国外以闭源为核心的分化态势,头部厂商普遍采用开源 + 闭源双轨策略;(1)技术层面:多模态原生融合、超长上下文、强编程能力、原生智能体能力、低推理成本(包括国产芯片适配)已成为旗舰模型五大标配特征;(2)商业模式层面:编程能力订阅套餐已与 API 按量付费、企业...

国内GPU卡全线飙涨原因分析

国内GPU卡全线飙涨原因分析
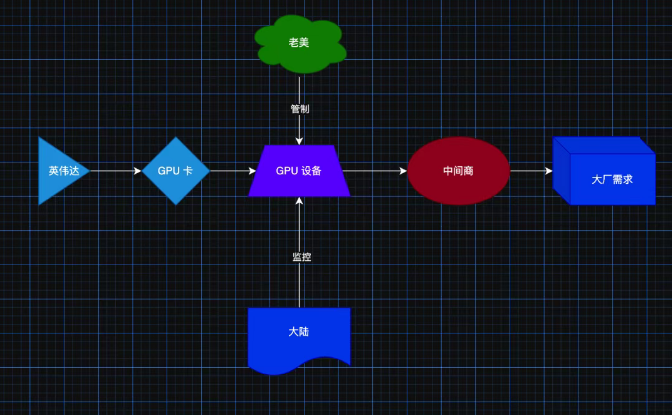
紧张升级5 月份,非常非常多的人寄希望于两个大佬谈判之后的的 GPU管制放松,特别是上一代 hopper架构的顶配算力卡松绑,弥补内部的算力不足,但是结果事与愿违,双方在 GPU 算力领域抓紧了卡脖子竞赛,彼此相互掐。(不要抱幻想了,干就完了)咱发布“韬定律”,引领未来半导体产业自主可控发展;对面发布史上最严 BIS 禁令...

总投资约50亿!交通银行贵安数据中心正式接入电网

总投资约50亿!交通银行贵安数据中心正式接入电网
2026年5月23日消息,交通银行贵安数据中心于近日已圆满完成全流程通电调试,正式接入电网,目前相关带电设备运行安全稳定。交通银行贵安数据中心项目位于贵安新区马场产业新城,是交通银行总行异地数据中心,也是贵州省重点工程。项目总投资约50亿元,总建筑面积约18万平方米,整体规划部署服务器超20万台,按照“整体规划、...

约20亿投资·140MW供电·万P算力·PUE低于1.23尚航无锡(惠山云)国际智算中心深度分析
约20亿投资·140MW供电·万P算力·PUE低于1.23尚航无锡(惠山云)国际智算中心深度分析
一、项目概况与战略定位尚航无锡(惠山云)国际智算中心位于无锡市惠山区锦惠路10号,是尚航科技在长三角枢纽布局的核心算力节点。项目于2017年启动建设,总投资超20亿元,占地近百亩,规划建筑面积约66600平方米,机柜总量15500个,IT容量近100MW。该中心是尚航科技环上海、环北京、环广州三大算力节点布局的关键一环,也是...
返回顶部